Quando un server non si avvia e i dati non sono più accessibili, la pressione per ripristinare rapidamente l’operatività può portare a eseguire troppi tentativi in poco tempo. Riavvii ripetuti, sostituzioni di dischi, rebuild RAID, procedure automatiche sul file system o reinstallazioni possono sembrare interventi logici, ma non sempre rappresentano la scelta più sicura quando l’infrastruttura contiene dati aziendali importanti.
Nelle prime ore di fermo bisogna distinguere due obiettivi differenti: ripristinare il servizio e preservare i dati. Le due esigenze possono coincidere, ma non è sempre così.
Con il nostro servizio di recupero dati da server analizziamo server non avviabili, sistemi RAID, server Windows e Linux, storage multi-disco e ambienti virtualizzati proprio partendo dalle condizioni effettive del sistema. Prima di intervenire è necessario capire se il problema riguarda hardware, controller, dischi, struttura RAID, file system o sistema operativo.
Server che non si avvia: individuare prima il punto in cui si ferma
L’espressione server non si avvia comprende situazioni tecnicamente molto diverse.
Un server completamente privo di alimentazione presenta uno scenario differente da una macchina che supera il POST ma non trova il volume di avvio. Allo stesso modo, un sistema operativo che non completa il boot non equivale a un server perfettamente avviato sul quale non risultano più accessibili database o cartelle condivise.
La prima operazione consiste quindi nel ricostruire esattamente il comportamento della macchina.
Occorre verificare se:
- il server riceve alimentazione;
- POST e diagnostica hardware vengono completati;
- controller e dischi vengono rilevati;
- il volume RAID viene riconosciuto;
- il bootloader viene eseguito;
- il sistema operativo inizia il caricamento;
- i volumi vengono montati correttamente;
- il sistema parte ma determinati servizi o dati rimangono indisponibili.
Questa distinzione riduce il rischio di applicare una procedura correttiva al livello sbagliato.
Centro Recupero Dati interviene, per esempio, sia su server che non si accendono o non completano l’avvio, sia su sistemi nei quali il problema interessa dischi SAS, SATA o SSD, controller RAID, configurazioni perse, file system corrotti, database e volumi non accessibili.
Prima priorità: preservare lo stato del sistema
Quando i dati sono importanti, la prima ora non dovrebbe essere una corsa ai tentativi.
Ogni operazione che modifica dischi, configurazioni o file system può rendere più difficile capire cosa sia realmente successo. In determinati scenari può anche peggiorare una situazione ancora recuperabile.
Il principio operativo dovrebbe essere semplice: osservare prima, modificare dopo.
Se un server ha improvvisamente perso l’accesso allo storage, non è prudente eseguire automaticamente tutti gli strumenti disponibili nella speranza che uno risolva il problema.
In particolare, è opportuno evitare senza una diagnosi:
- riavvii continui;
- inizializzazione dei dischi;
- reinstallazione del sistema operativo;
- formattazioni;
- procedure automatiche sul file system;
- sostituzione casuale delle unità;
- rebuild RAID avviati senza conoscere lo stato dei supporti.
Noi di Centro Recupero Dati raccomandiamo di evitare tentativi improvvisati, perché riavvii, rebuild e procedure automatiche possono modificare ulteriormente una situazione compromessa.
Controllare subito lo stato del RAID
Quando il server utilizza uno storage RAID, il controller rappresenta uno dei punti da controllare nelle prime fasi.
Bisogna capire come viene attualmente vista la configurazione e quali eventi hanno preceduto il fermo.
Un array che risulta degradato è diverso da un volume completamente fallito. Anche il numero di dischi che il controller considera offline cambia radicalmente lo scenario.
Prima di sostituire qualsiasi supporto è utile documentare:
- stato dell’array;
- numero e posizione dei dischi;
- eventuali unità segnalate come failed;
- presenza di hot spare;
- messaggi del controller;
- eventuali rebuild già avviati;
- modifiche recenti alla configurazione.
Particolare attenzione va riservata all’ordine fisico dei dischi. Nei sistemi multi-disco la ricostruzione dei dati dipende dalla configurazione dell’array e dai parametri con cui i dati sono distribuiti sui supporti.
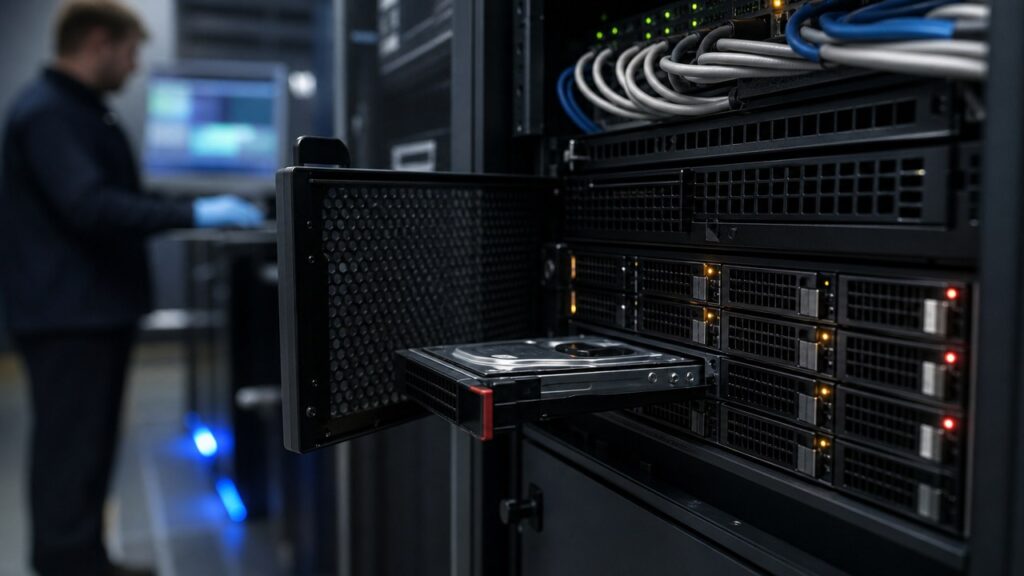
Centro Recupero Dati opera su configurazioni RAID 0, RAID 1, RAID 5, RAID 6, RAID 10, JBOD e storage multi-disco. In fase di analisi vengono considerati configurazione, numero di unità, tipo di guasto e operazioni eventualmente già eseguite.
Un rebuild RAID non equivale a un recupero dei dati
Uno degli errori più delicati durante un fermo consiste nel considerare il rebuild come una procedura sempre sicura.
Il rebuild nasce per ricostruire la ridondanza di un array utilizzando i dati ancora disponibili. Non è però uno strumento universale per recuperare qualsiasi configurazione RAID compromessa.
Se più dischi presentano problemi, se la sequenza non è certa oppure se l’array è già stato modificato, forzare una ricostruzione può produrre ulteriori scritture sui supporti.
Per questo bisogna prima capire quale unità abbia generato il primo problema e quale sia lo stato effettivo degli altri dischi.
Se un rebuild è già fallito, continuare a ripeterlo senza conoscere la causa aumenta la complessità del caso. Il rebuild fallito rientra infatti tra gli scenari sui quali interveniamo nelle attività di recupero dati da server.
Verificare il backup prima di modificare il server
La presenza di un sistema di backup può cambiare completamente la gestione dell’emergenza, ma soltanto se il backup è realmente disponibile e utilizzabile.
Non basta sapere che esiste un software di backup o che una procedura era stata configurata mesi prima.
Nelle prime ore occorre verificare quando sia stato completato l’ultimo job, se siano presenti errori, quali dati siano effettivamente inclusi e se il repository sia accessibile indipendentemente dal server coinvolto.
Bisogna inoltre distinguere tra backup, replica e snapshot. Sono strumenti differenti e non garantiscono necessariamente lo stesso livello di protezione.
Prima di sovrascrivere o ricostruire il sistema originale è quindi utile rispondere a tre domande:
Qual è l’ultima copia verificata? Quali dati contiene? Quanto lavoro recente manca rispetto al momento del fermo?
Un backup non verificato non dovrebbe essere considerato automaticamente una rete di sicurezza.
Documentare cosa è successo prima del fermo
Durante un’emergenza questa attività viene spesso trascurata, ma può ridurre enormemente i tempi della diagnosi.
Bisogna ricostruire la cronologia tecnica delle ore o dei giorni precedenti.
Un blackout, per esempio, indirizza l’analisi verso scenari diversi rispetto a un server che ha iniziato a rallentare progressivamente per diversi giorni.
Annota eventuali:
- blackout o sbalzi di tensione;
- errori hardware precedenti;
- sostituzioni recenti di dischi;
- alert SMART;
- rebuild precedenti;
- aggiornamenti del sistema operativo;
- modifiche al controller;
- rallentamenti dello storage;
- backup falliti;
- riavvii imprevisti;
- segnalazioni di malware o ransomware.
Queste informazioni aiutano a capire se il fermo sia un evento isolato oppure il punto finale di un deterioramento già in corso.
Server non avviabile dopo un blackout
Un’interruzione improvvisa dell’alimentazione può interessare più livelli contemporaneamente.
Il sistema operativo potrebbe non essersi chiuso correttamente, il file system potrebbe trovarsi in uno stato incoerente oppure una o più unità potrebbero non tornare online al riavvio.
In altre situazioni il problema può interessare alimentatori, controller o altri componenti hardware.
Il fatto che il problema sia comparso dopo un blackout non permette quindi di stabilire immediatamente quale componente sia responsabile.
Centro Recupero Dati include proprio blackout e sbalzi di corrente tra le condizioni che possono determinare perdita di accesso ai dati sui server.
Server bloccato dopo un aggiornamento: distinguere sistema operativo e storage
Se il server smette di avviarsi subito dopo un aggiornamento, è naturale attribuire il problema al software.
Prima di procedere con rollback, reinstallazioni o altre modifiche bisogna però verificare che i volumi e lo storage siano effettivamente integri.
Un problema di boot può riguardare esclusivamente il sistema operativo, mentre i dati rimangono perfettamente presenti sui volumi. In altri casi l’aggiornamento può semplicemente aver reso evidente un problema preesistente dello storage.
La distinzione è fondamentale perché ripristinare il sistema operativo e recuperare i dati sono due attività differenti.
Se il valore principale risiede nei database, nei gestionali o negli archivi aziendali, la priorità deve rimanere la protezione di quelle informazioni.
Se il server ospita database e macchine virtuali
L’accessibilità dei singoli file non è sempre sufficiente.
Un server può contenere database, macchine virtuali, archivi email o applicazioni che dipendono dalla coerenza di più file collegati tra loro.
Nel caso di VMware o Hyper-V, per esempio, il dato prioritario può essere rappresentato dai componenti necessari alla macchina virtuale e non da un singolo documento.
Allo stesso modo, recuperare alcuni file appartenenti a un database non significa automaticamente avere ottenuto un database consistente e utilizzabile.
Noi di Centro Recupero Dati lavoriamo anche su ambienti Windows Server, Linux, VMware, Hyper-V, database, gestionali, archivi email, backup e cartelle condivise. Quando necessario, le attività possono essere eseguite lavorando su copie tecniche dei supporti per limitare ulteriori scritture sugli originali.
Se ci sono segnali di ransomware, isolare prima di ripristinare
Un server che improvvisamente presenta dati non accessibili non è necessariamente vittima di ransomware, ma alcuni segnali richiedono verifiche immediate.
Estensioni dei file cambiate, note anomale, archivi cifrati, condivisioni improvvisamente inutilizzabili o attività sospette su più sistemi possono indicare un incidente di sicurezza.
In questo scenario la priorità cambia.
Prima di cercare di ripristinare il normale funzionamento bisogna impedire che l’evento continui a propagarsi verso altri server, backup o storage raggiungibili dalla rete.
Recuperare i dati e bonificare l’infrastruttura sono inoltre due problemi distinti e devono essere gestiti come tali.
Stabilire quali dati hanno davvero priorità
Durante un fermo aziendale non tutti i dati hanno necessariamente la stessa urgenza.
Se il server contiene molti terabyte di informazioni, tentare di ripristinare tutto contemporaneamente può non essere la strategia più efficiente.
Conviene identificare prima ciò che blocca realmente l’attività.
La priorità potrebbe essere rappresentata da:
- database di produzione;
- gestionale aziendale;
- macchine virtuali critiche;
- file contabili e amministrativi;
- progetti in lavorazione;
- cartelle condivise operative;
- archivi storici.
Definire questa gerarchia permette di distinguere ciò che deve tornare disponibile rapidamente da ciò che può essere recuperato successivamente.
Quando interrompere il troubleshooting interno
Non esiste un punto identico per ogni infrastruttura, ma alcuni segnali suggeriscono che ulteriori tentativi debbano essere valutati con estrema prudenza.
È consigliabile fermarsi quando più dischi risultano contemporaneamente guasti, la configurazione RAID non è più riconosciuta, un rebuild è fallito, i supporti producono rumori anomali oppure il controller mostra una struttura differente da quella attesa.
Lo stesso vale quando non esiste un backup verificato e i dati presenti sul server sono fondamentali per l’attività.
In queste condizioni ogni nuova scrittura può diventare più importante del tempo risparmiato da un tentativo improvvisato.
Una diagnosi tecnica permette di analizzare lo stato dei singoli supporti, ricostruire la configurazione e scegliere la procedura con un quadro molto più chiaro. È l’approccio che adottiamo noi di Centro Recupero Dati sui server aziendali non avviabili e sui sistemi di storage compromessi.
Le prime ore di fermo possono determinare le possibilità di recupero
Quando un server aziendale si ferma, agire rapidamente è importante. Rapidità, però, non significa necessariamente eseguire subito una riparazione.
Significa raccogliere le informazioni corrette, evitare operazioni distruttive, verificare RAID e backup, preservare la configurazione e stabilire quali dati abbiano priorità.
Un server che non si avvia può avere un problema relativamente circoscritto oppure presentare più guasti contemporaneamente. Prima di intervenire bisogna capire quale dei due scenari si ha davanti.
La scelta più efficace nelle prime ore è quindi quella che mantiene aperte il maggior numero possibile di opzioni di ripristino e recupero.
FAQ sul server che non si avvia
Conviene riavviare più volte un server che non parte?
No. Se il primo riavvio non risolve il problema e sono presenti errori relativi a dischi, RAID o file system, continuare a riavviare può non essere prudente. Prima è opportuno identificare il livello sul quale si verifica il guasto.
Posso sostituire immediatamente il disco indicato come guasto?
Dipende dalla configurazione e dallo stato degli altri supporti. Nei sistemi RAID è importante conoscere struttura, posizione delle unità e cronologia degli errori prima di effettuare sostituzioni.
Un RAID degradato significa che i dati sono già persi?
Non necessariamente. Un array degradato può continuare a rendere disponibili i dati, ma presenta una condizione di rischio che deve essere valutata prima di rebuild o altre modifiche.
È sempre sicuro effettuare il rebuild del RAID?
No. Il rebuild deve essere eseguito quando configurazione e stato dei dischi sono noti. Se più unità presentano problemi o l’array è già compromesso, una ricostruzione non controllata può modificare ulteriormente i dati.
Posso reinstallare il sistema operativo se il server non si avvia?
Se sono presenti dati importanti, è preferibile verificare prima lo stato dei volumi. La reinstallazione può comportare modifiche allo storage e non risolve necessariamente problemi legati a RAID, dischi o file system.
È possibile recuperare dati da un server completamente non avviabile?
In molti casi può essere possibile. La fattibilità dipende dal tipo di guasto, dalla configurazione dello storage, dallo stato dei dischi e dalle operazioni già effettuate. Centro Recupero Dati analizza server non avviabili, sistemi RAID, storage aziendali e ambienti virtualizzati proprio per stabilire le possibilità di recupero.